


 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
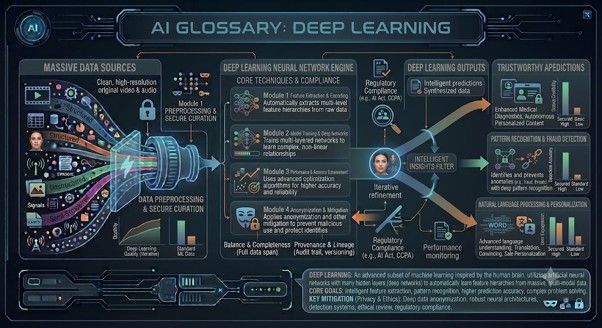
Hluboké učení
Hluboké učení je typ strojového učení založený na neuronových sítích s mnoha vrstvami. Tyto systémy se dokážou učit rozpoznávat složité vzory v obrázcích, textech, zvukových záznamech a videích. Hluboké učení je základem mnoha moderních průlomů v oblasti umělé inteligence, včetně rozpoznávání řeči, generování obrázků, překladu a rozsáhlých jazykových modelů. Často vyžaduje velké množství dat a výpočetního výkonu.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
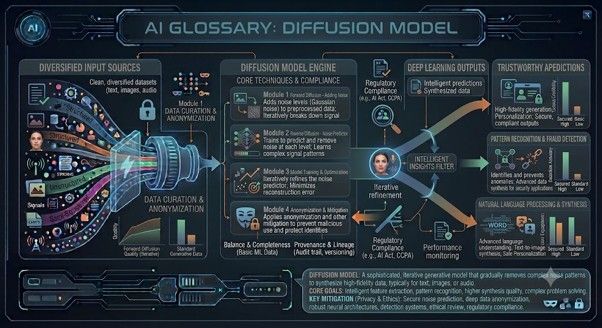
Difúzní model
Difúzní model je typ generativní umělé inteligence, který se často používá k vytváření obrázků. Naučí se generovat data tak, že začíná s šumem a postupně jej zušlechťuje do soudržného obrázku nebo výstupu. Mnoho moderních nástrojů pro generování obrázků využívá difúzní techniky. Výsledek může být velmi realistický nebo umělecký, v závislosti na zadání a modelu.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
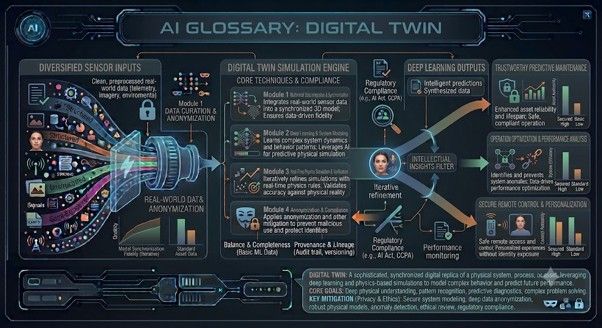
Digitální dvojče
Digitální dvojče je virtuální model reálného objektu, systému nebo procesu. Například továrna může mít digitální dvojče, které simuluje stroje, spotřebu energie a výrobní tok. Umělá inteligence může digitální dvojčata vylepšit tím, že předpovídá problémy a testuje změny ještě předtím, než k nim dojde v reálném světě. Digitální dvojčata se používají ve strojírenství, zdravotnictví, dopravě a v inteligentních městech.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
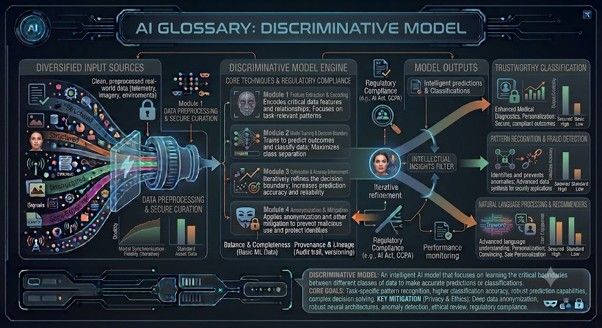
Diskriminační model
Diskriminační model se učí rozlišovat mezi kategoriemi. Může například rozhodnout, zda je e-mail spamem či nikoli, nebo zda se snímek nádoru jeví jako benigní či maligní. Diskriminační modely se liší od generativních modelů, které vytvářejí nový obsah. Zjednodušeně řečeno, diskriminační modely klasifikují; generativní modely produkují.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
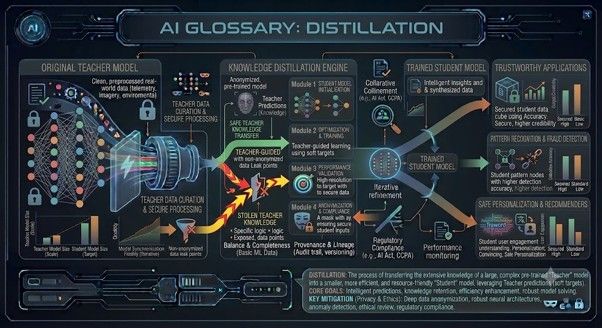
Destilace
Destilace AI spočívá v trénování malého, rychlého modelu AI tak, aby kopíroval znalosti a chování velkého, chytrého modelu AI. Představte si to jako šéfkuchaře (velký model), který učí svého učně (malý model) všechny své tajné recepty a techniky, aby učedník mohl vařit jídlo stejné kvality, jen mnohem rychleji a s menším počtem kuchyňských nástrojů.Proč se používá: Šetří místo: Zmenšuje rozsáhlé systémy umělé inteligence tak, aby se vešly do smartphonu nebo notebooku. Šetří peníze: Provoz menšího modelu vyžaduje výrazně méně výpočetního výkonu. Šetří čas: Menší model poskytuje odpovědi mnohem rychleji než ten obrovský.
 Zdroje: Poskytnutý obrázek; Autor: Stephen Whitelaw;
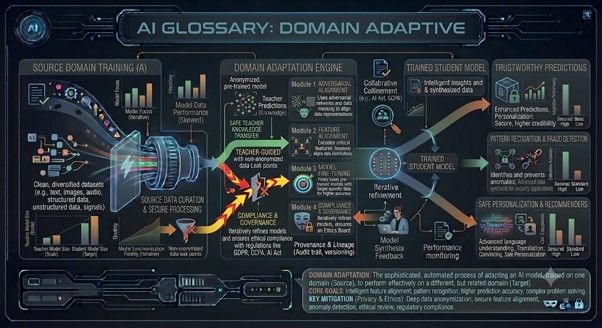
Adaptace domény
Adaptace domény je proces, díky kterému model umělé inteligence dobře funguje v novém, ale souvisejícím prostředí. Například model trénovaný na nemocničních datech z jedné země nemusí fungovat stejně dobře v jiné zemi, protože se liší vybavení, pacienti nebo postupy. Adaptace domény pomáhá modelům přenášet znalosti a zároveň se přizpůsobovat místním podmínkám.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
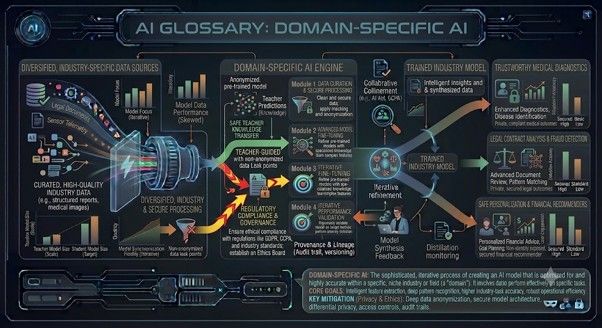
Doménově specifická AI
Doménově specifická AI je umělá inteligence navržená pro konkrétní obor, jako je zdravotnictví, právo, finance, vzdělávání, zemědělství nebo výroba. Tyto systémy mohou být přesnější a užitečnější než obecné nástroje, protože jsou postaveny na odborných znalostech a pracovních postupech. Doménově specifická AI však vyžaduje dohled odborníků, protože chyby mohou mít vážné důsledky.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
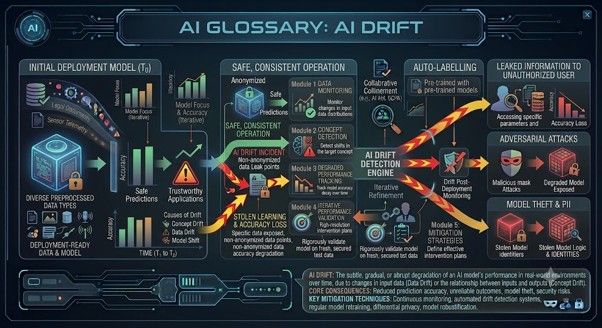
Odchylka
K driftu dochází, když se výkon modelu umělé inteligence v průběhu času mění v důsledku změn v reálném světě. Může se například měnit chování zákazníků, taktiky podvodníků, lékařská praxe nebo používání jazyka. Model, který loni fungoval dobře, může být dnes méně spolehlivý. Sledování driftu je nezbytné u každého systému umělé inteligence, který se používá dlouhodobě.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
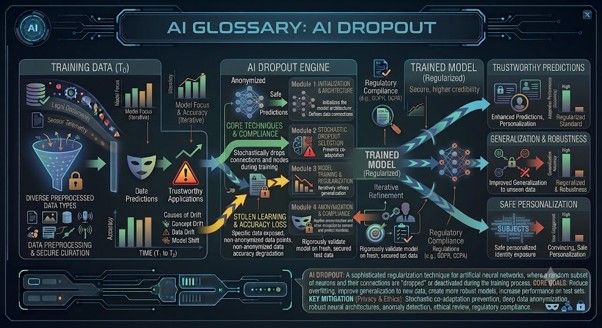
Dropout
Dropout je trénovací technika používaná v neuronových sítích ke snížení nadměrného přizpůsobení (overfitting). Během tréninku jsou některé spojení náhodně ignorována, což nutí model, aby se příliš nespoléhal na žádnou jednotlivou cestu. To pomáhá modelu lépe generalizovat na nová data. Je to podobné jako trénování týmu tak, aby celá skupina podávala dobrý výkon, místo aby se spoléhala na jednoho hvězdného hráče.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
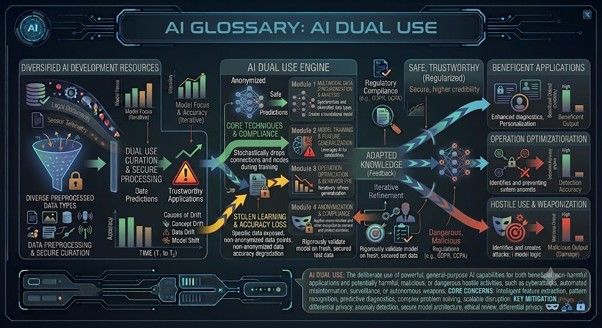
Dvojí použití
Dvojí využití znamená, že technologie může být použita jak k užitečným, tak ke škodlivým účelům. Umělá inteligence je klasickou technologií s dvojím využitím. Stejný nástroj, který pomáhá psát vzdělávací materiály, by mohl pomoci i při psaní phishingových e-mailů. Stejný systém generování obrázků, který pomáhá umělcům, by mohl vytvářet falešné důkazy. Odpovědná umělá inteligence vyžaduje zohlednění jak zamýšleného použití, tak i možného zneužití.
Nastavte The Portugal News jako svuj preferovany zdroj zprav na Googlu
 Pridat jako preferovany zdroj na Googlu


 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media