


 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
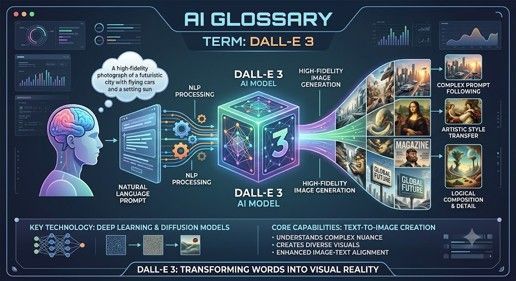
Dall-E 3
DALL-E 3 byl model pro převod textu na obrázek založený na hlubokém učení, vyvinutý společností OpenAI, který generoval detailní obrázky ve vysokém rozlišení na základě popisů v přirozeném jazyce (promptů). Byl uveden na trh koncem roku 2023 a představoval významný pokrok oproti předchozím generativním vizuálním modelům, protože výrazně zlepšil dodržování zadání, kvalitu obrázků a vykreslování složitých detailů.
Klíčové vlastnosti a schopnosti
· Porozumění přirozenému jazyku: Model je nativně navržen tak, aby rozuměl jemným nuancím, prostorovým vztahům a detailnímu kontextu v uživatelských zadáních, aniž by vyžadoval složité „prompt engineering“.
· Zobrazení textu v obrázku: Schopnost generovat jasný a čitelný text vložený přímo do obrázků (např. nápisy, štítky, loga).
· Integrace s ChatGPT: Nativně integrováno do ChatGPT Plus/Enterprise, což uživatelům umožňuje konverzačním způsobem brainstormovat, vylepšovat a iterovat vizuální zadání.
· Bezpečnost a původ: Obsahuje vestavěné bezpečnostní mechanismy, které zabraňují generování explicitního obsahu, karikatur veřejných osobností nebo napodobování stylu žijících umělců, a využívá metadata o původu C2PA k identifikaci obrázků generovaných umělou inteligencí.
Pozn.: DALL-E 3 se již většinou standardně nepoužívá, protože společnosti OpenAI a Microsoft jej oficiálně vyřadily z provozu a označily za zastaralý. Nahradily jej novější nativní multimodální systémy
 Zdroje: Poskytnutý obrázek; Autor: Stephen Whitelaw;
Data
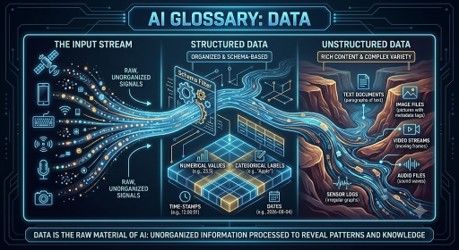
Data jsou surovinou, kterou využívají systémy umělé inteligence. Mohou zahrnovat text, obrázky, zvuk, video, čísla, transakce, údaje ze senzorů nebo lékařské záznamy. Systémy umělé inteligence se z dat učí rozpoznávat vzorce. Kvalita, relevance a nestrannost dat jsou zásadní. Špatná data mohou vést ke špatné umělé inteligenci, bez ohledu na to, jak pokročilý se model jeví.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
Rozšíření dat
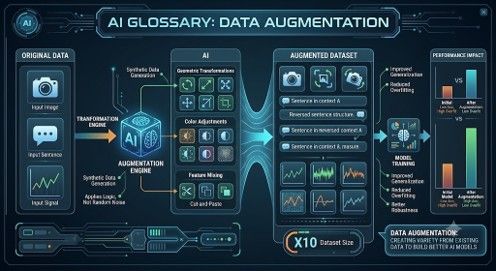
Rozšíření dat znamená vytváření upravených verzí stávajících trénovacích příkladů za účelem vylepšení modelu. U obrázků to může zahrnovat otočení, oříznutí nebo změnu jasu. U textu může jít o parafrázi. Cílem je zvýšit robustnost modelu tím, že jej vystavíme různým variantám. Rozšíření dat je obzvláště užitečné, když je původní datový soubor omezený.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
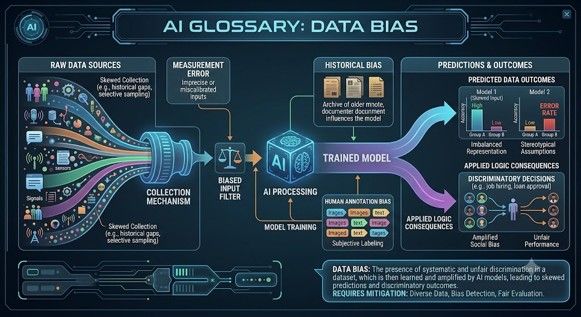
Zkreslení dat
Zkreslení dat nastává, když data použitá k trénování nebo testování systému umělé inteligence nejsou reprezentativní, jsou neúplná nebo zkreslená. Například systém rozpoznávání obličeje, který byl trénován převážně na jedné demografické skupině, může u jiných skupin podávat horší výsledky. Zkreslení dat je jednou z hlavních příčin nespravedlivého nebo nespolehlivého chování umělé inteligence.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
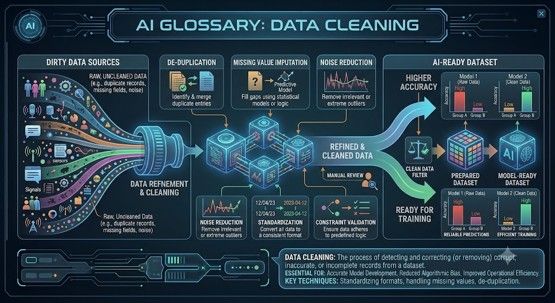
Čištění dat
Čištění dat je proces opravy, odstranění nebo uspořádání neuspořádaných dat před jejich použitím. Data z reálného světa často obsahují duplikáty, chybějící hodnoty, pravopisné chyby, zastaralé záznamy nebo nekonzistentní formáty. Systémy umělé inteligence jsou silně závislé na čistých datech. V mnoha projektech zabere čištění dat více času než vytvoření samotného modelu.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
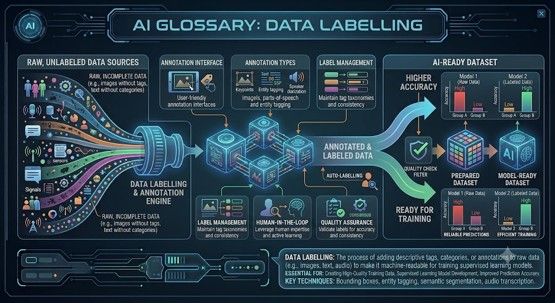
Označování dat
Označování dat je proces přidávání smysluplných štítků k datům, aby se z nich systém umělé inteligence mohl učit. Například označení e-mailů jako „spam“ nebo „není spam“ pomáhá trénovat spamový filtr. Označování lékařských snímků může pomoci trénovat diagnostické nástroje. Správné označování vyžaduje jasná pravidla a kontrolu kvality, zejména když je zapotřebí odborný úsudek.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
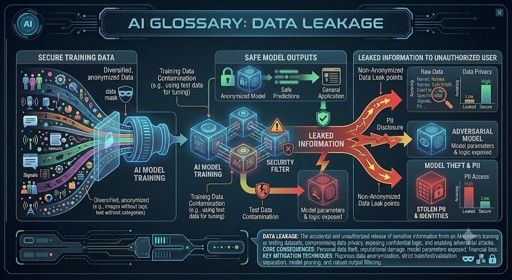
Únik dat
K úniku dat dochází, když informace z testovacích dat náhodně ovlivní proces trénování. Model pak vypadá lépe, než ve skutečnosti je. Pokud je například model trénován pomocí informací, které by v reálném životě nebyly k dispozici, stává se odhad jeho výkonu nespolehlivým. Únik dat je běžnou, ale závažnou chybou v projektech strojového učení.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
Těžba dat
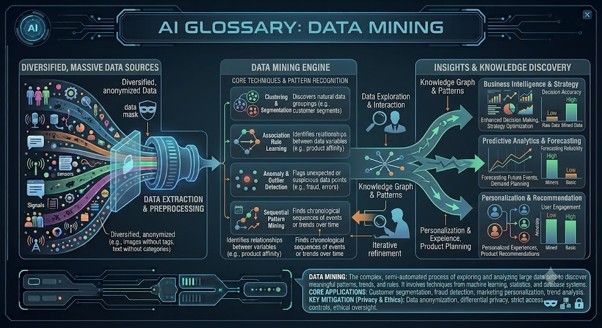
Těžba dat je proces hledání vzorců, vztahů nebo užitečných informací ve velkých datových souborech. Existovala již před moderní umělou inteligencí, ale překrývá se se strojovým učením. Podniky využívají těžbu dat k porozumění zákazníkům, odhalování podvodů, předpovídání poptávky a zlepšování provozních procesů. Riziko spočívá v tom, že vzorce mohou být nesprávně interpretovány nebo použity bez náležitých opatření na ochranu soukromí.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
Ochrana osobních údajů
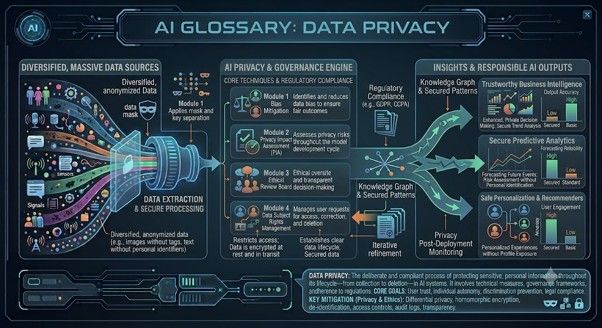
Ochrana osobních údajů se týká způsobu, jakým jsou osobní údaje shromažďovány, využívány, uchovávány a sdíleny. Umělá inteligence přináší nové obavy ohledně ochrany osobních údajů, protože modely mohou být trénovány na rozsáhlých datových souborech, které obsahují i citlivé informace. Organizace využívající umělou inteligenci musí zohlednit otázky souhlasu, bezpečnosti, anonymizace, uchovávání dat a dodržování právních předpisů. Ochrana osobních údajů není pouze technickou záležitostí; je to otázka důvěry.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
Datový soubor
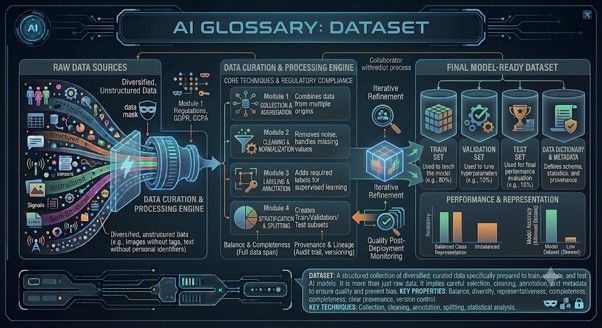
Datový soubor je strukturovaný soubor dat používaný k trénování, testování nebo analýze systému umělé inteligence. Datový soubor může obsahovat záznamy o zákaznících, lékařské snímky, recenze produktů, finanční transakce nebo označené fotografie. Velikost, kvalita a reprezentativnost datového souboru výrazně ovlivňují výkon modelu.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
Rozhodovací strom
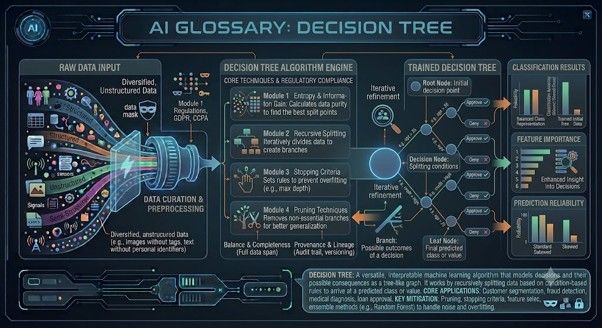
Rozhodovací strom je model strojového učení, který provádí rozhodování prostřednictvím řady otázek. Například: Je zákazník starší 18 let? Došlo již dříve k neúspěšné platbě? Je transakce neobvykle vysoká? Rozhodovací stromy jsou oblíbené, protože jsou srozumitelnější než mnoho modelů typu „black-box“. Často se používají při hodnocení rizik, klasifikaci a obchodních pravidlech.
 Zdroj: Poskytnutý obrázek; Autor: Stephen Whitelaw;
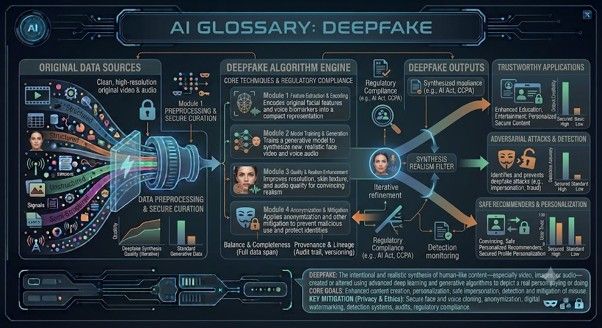
Deepfake
Deepfake je médium generované nebo manipulované umělou inteligencí, které vyvolává dojem, že někdo říká nebo dělá něco, co ve skutečnosti neřekl ani neudělal. Deepfake lze využít pro zábavu, ale také k podvodům, obtěžování, šíření dezinformací a politické manipulaci. Vzhledem k tomu, že deepfake jsou stále realističtější, nabývá mediální gramotnost a ověřování informací na významu.
Nastavte The Portugal News jako svuj preferovany zdroj zprav na Googlu
 Pridat jako preferovany zdroj na Googlu


 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media