


 Källa: Tillhandahållen bild; Författare: Stephen Whitelaw;
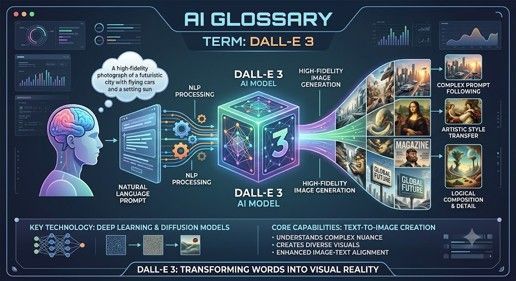
Dall-E 3
DALL-E 3 var en deep learning-baserad text-till-bild-modell utvecklad av OpenAI som genererade detaljerade bilder med hög upplösning utifrån beskrivningar i naturligt språk (prompts). Modellen släpptes i slutet av 2023 och utgjorde en betydande vidareutveckling jämfört med tidigare generativa visuella modeller genom att avsevärt förbättra följsamheten gentemot prompten, bildkvaliteten och återgivningen av komplexa detaljer.
Viktiga funktioner och egenskaper
· Inbyggd språkförståelse: Inbyggd förmåga att förstå subtila nyanser, rumsliga relationer och detaljerad kontext i användarens prompt utan behov av komplex ”prompt engineering”.
· Textåtergivning i bilder: Kan generera tydlig, läsbar text som är inbäddad direkt i bilder (t.ex. skyltar, etiketter, logotyper).
· ChatGPT-integration: Integrerad direkt i ChatGPT Plus/Enterprise, vilket gör det möjligt för användare att brainstorma, förfina och iterera kring visuella promptar på ett konversationsliknande sätt.
· Säkerhet och härkomst: Innehåller inbyggda säkerhetsmekanismer för att förhindra generering av explicit innehåll, karikatyrer av offentliga personer eller stilimitationer av levande konstnärer, och använder C2PA-metadata för härkomst för att identifiera AI-genererade bilder.
Obs! DALL-E 3 används i stort sett inte längre som standard eftersom OpenAI och Microsoft officiellt har tagit det ur bruk och avskaffat det. Det har ersatts av nyare inbyggda multimodala system
 Källhänvisning: Tillhandahållen bild; Författare: Stephen Whitelaw;
Data
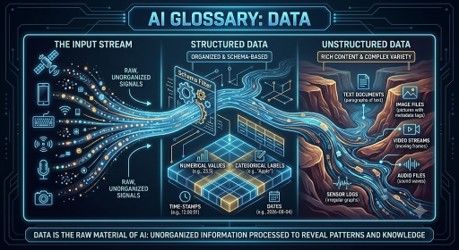
Data är det råmaterial som används av AI-system. Det kan omfatta text, bilder, ljud, video, siffror, transaktioner, sensoravläsningar eller medicinska journaler. AI-system lär sig mönster från data. Datans kvalitet, relevans och rättvisa är avgörande. Dålig data kan leda till dålig AI, oavsett hur avancerad modellen verkar vara.
 Källa: Tillhandahållen bild; Författare: Stephen Whitelaw;
Dataaugmentering
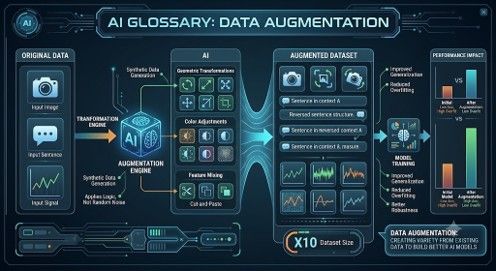
Dataaugmentering innebär att man skapar modifierade versioner av befintliga tränings exempel för att förbättra en modell. För bilder kan detta innebära att man roterar, beskär eller ändrar ljusstyrkan. För text kan det handla om att omformulera. Målet är att göra modellen mer robust genom att utsätta den för variation. Dataaugmentering är särskilt användbart när den ursprungliga datamängden är begränsad.
 Källa: Bild tillhandahållen; Författare: Stephen Whitelaw;
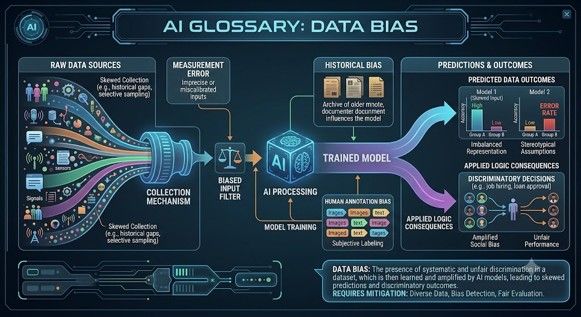
Databias
Databias uppstår när de data som används för att träna eller testa ett AI-system är icke-representativa, ofullständiga eller skeva. Till exempel kan ett ansiktsigenkänningssystem som huvudsakligen tränats på en demografisk grupp prestera sämre på andra grupper. Databias är en av de främsta orsakerna till orättvist eller opålitligt AI-beteende.
 Källa: Bild tillhandahållen; Författare: Stephen Whitelaw;
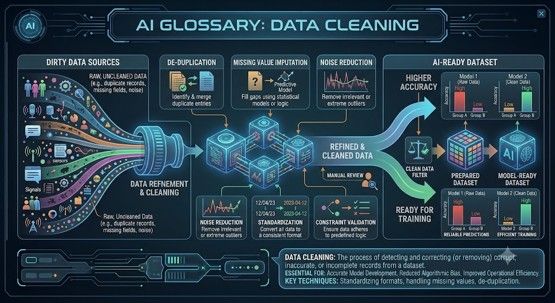
Datarensning
Datarensning är processen att korrigera, ta bort eller organisera orediga data innan de används. Data från verkligheten innehåller ofta dubbletter, saknade värden, stavfel, föråldrade poster eller inkonsekventa format. AI-system är starkt beroende av rena data. I många projekt tar datarensningen längre tid än att bygga modellen.
 Källa: Tillhandahållen bild; Författare: Stephen Whitelaw;
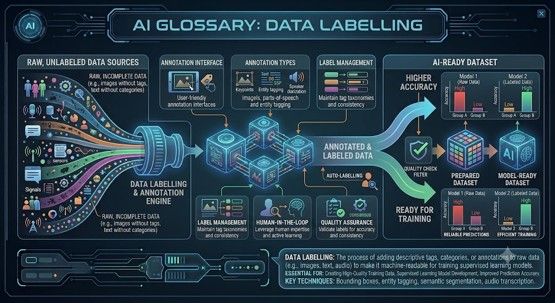
Datamärkning
Datamärkning är processen att lägga till meningsfulla etiketter till data så att ett AI-system kan lära sig av dem. Att till exempel märka e-postmeddelanden som ”skräppost” eller ”inte skräppost” hjälper till att träna ett skräppostfilter. Att märka medicinska bilder kan hjälpa till att träna diagnostiska verktyg. God märkning kräver tydliga regler och kvalitetskontroll, särskilt när expertbedömning behövs.
 Källa: Tillhandahållen bild; Författare: Stephen Whitelaw;
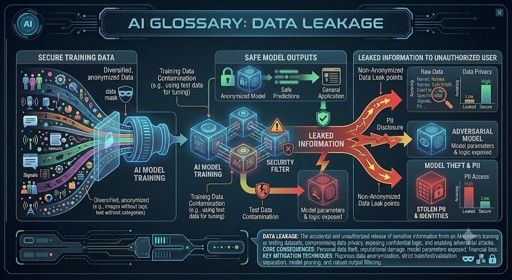
Dataläckage
Dataläckage uppstår när information från testdata av misstag påverkar träningsprocessen. Detta gör att modellen framstår som bättre än den egentligen är. Om en modell till exempel tränas med hjälp av information som inte skulle finnas tillgänglig i verkligheten blir prestandauppskattningen opålitlig. Dataläckage är ett vanligt men allvarligt misstag i projekt inom maskininlärning.
 Källa: Bild tillhandahållen; Författare: Stephen Whitelaw;
Datautvinning
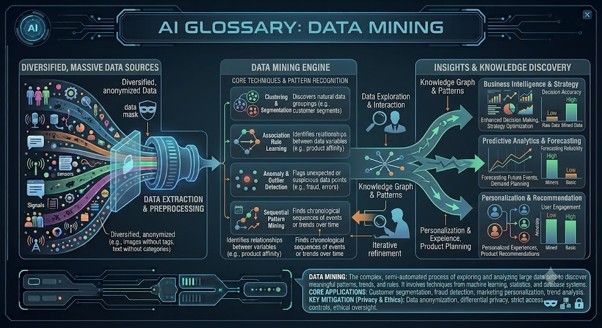
Datautvinning är processen att hitta mönster, samband eller användbar information i stora datamängder. Den fanns redan före modern AI men överlappar maskininlärning. Företag använder datautvinning för att förstå kunder, upptäcka bedrägerier, prognostisera efterfrågan och förbättra verksamheten. Risken är att mönster kan misstolkas eller användas utan adekvata integritetsskyddsåtgärder.
 Källa: Tillhandahållen bild; Författare: Stephen Whitelaw;
Dataskydd
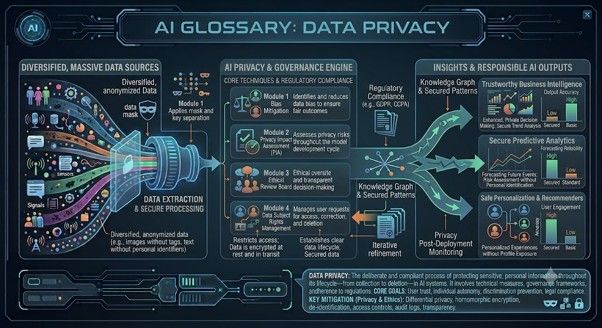
Dataskydd handlar om hur personuppgifter samlas in, används, lagras och delas. AI skapar nya integritetsfrågor eftersom modellerna kan tränas på stora datamängder, inklusive känslig information. Organisationer som använder AI måste ta hänsyn till samtycke, säkerhet, anonymisering, lagringstid och efterlevnad av lagstiftningen. Integritet är inte bara en teknisk fråga, utan också en fråga om förtroende.
 Källa: Bild tillhandahållen; Författare: Stephen Whitelaw;
Datamängd
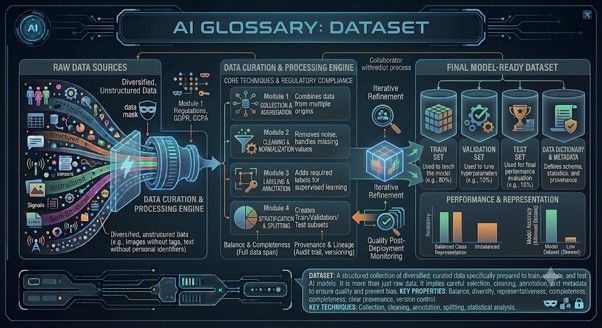
En datamängd är en strukturerad samling data som används för att träna, testa eller analysera ett AI-system. En datamängd kan innehålla kundregister, medicinska bilder, produktrecensioner, finansiella transaktioner eller märkta fotografier. Datamängdens storlek, kvalitet och representativitet har stor inverkan på modellens prestanda.
 Källa: Tillhandahållen bild; Författare: Stephen Whitelaw;
Beslutsträd
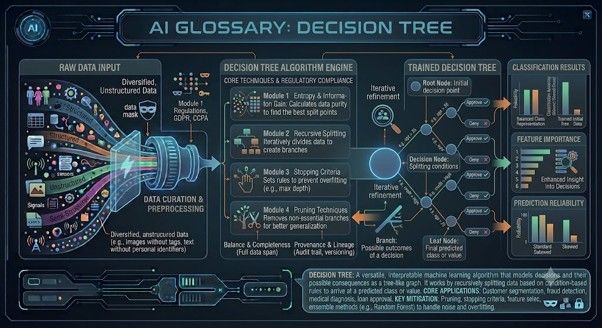
Ett beslutsträd är en maskininlärningsmodell som fattar beslut genom en sekvens av frågor. Till exempel: Är kunden över 18 år? Har betalningen misslyckats tidigare? Är transaktionen ovanligt stor? Beslutsträd är populära eftersom de är lättare att förstå än många black-box-modeller. De används ofta vid riskbedömning, klassificering och affärsregler.
 Källa: Tillhandahållen bild; Författare: Stephen Whitelaw;
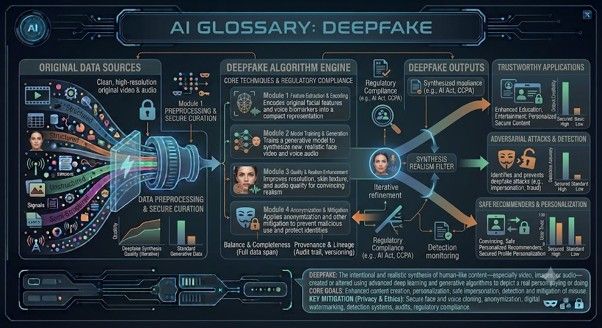
Deepfake
En deepfake är AI-genererat eller AI-manipulerat material som får någon att framstå som om de säger eller gör något som de inte har sagt eller gjort. Deepfakes kan användas för underhållning, men också för bedrägeri, trakasserier, desinformation och politisk manipulation. I takt med att deepfakes blir mer realistiska blir mediekunskap och verifiering allt viktigare.
Ange The Portugal News som din föredragna nyhetskälla på Google
 Lägg till som föredragen källa på Google


 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media