


 Bildnachweis: Bild zur Verfügung gestellt; Autor: Stephen Whitelaw;
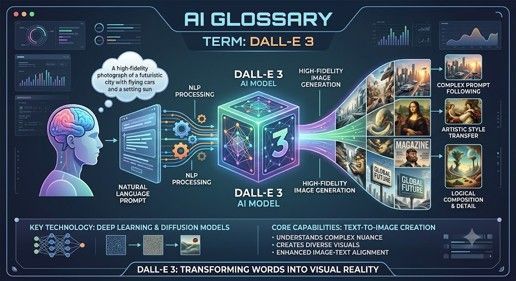
Dall-E 3
DALL-E 3 war ein von OpenAI entwickeltes Deep-Learning-Modell zur Text-zu-Bild-Generierung, das aus Beschreibungen in natürlicher Sprache (Prompts) detaillierte, hochauflösende Bilder erzeugte. Es wurde Ende 2023 veröffentlicht und stellte eine bedeutende Weiterentwicklung gegenüber früheren generativen Bildmodellen dar, da es die Einhaltung der Vorgaben, die Bildqualität und die Darstellung komplexer Details erheblich verbesserte.
Wichtigste Funktionen und Fähigkeiten
· Verständnis der natürlichen Sprache: Von Grund auf darauf ausgelegt, subtile Nuancen, räumliche Beziehungen und detaillierte Zusammenhänge in den Eingabeaufforderungen der Nutzer zu verstehen, ohne dass komplexes „Prompt Engineering“ erforderlich ist.
· Textdarstellung in Bildern: Kann klaren, gut lesbaren Text generieren, der direkt in Bilder eingebettet ist (z. B. Schilder, Beschriftungen, Logos).
· ChatGPT-Integration: Nativ in ChatGPT Plus/Enterprise integriert, sodass Nutzer visuelle Eingabeaufforderungen im Dialog entwickeln, verfeinern und iterieren können.
· Sicherheit & Herkunft: Verfügt über integrierte Sicherheitsvorkehrungen, um die Erzeugung expliziter Inhalte, Karikaturen von Persönlichkeiten des öffentlichen Lebens oder Stilimitationen lebender Künstler zu verhindern, und nutzt C2PA-Herkunftsmetadaten zur Identifizierung KI-generierter Bilder.
Anmerkung: DALL-E 3 wird größtenteils nicht mehr standardmäßig verwendet, da OpenAI und Microsoft es offiziell aus dem Verkehr gezogen und als veraltet eingestuft haben. Es wurde durch neuere native multimodale Systeme ersetzt
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
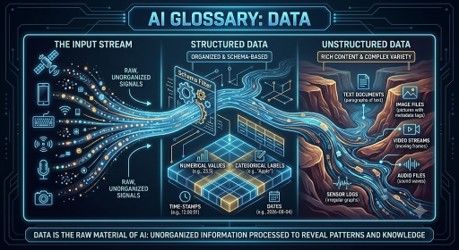
Daten
Daten sind das Rohmaterial, das von KI-Systemen verwendet wird. Dazu können Text, Bilder, Audio, Video, Zahlen, Transaktionen, Sensorwerte oder medizinische Unterlagen gehören. KI-Systeme lernen Muster aus Daten. Die Qualität, Relevanz und Fairness der Daten sind entscheidend. Schlechte Daten können zu schlechter KI führen, egal wie fortschrittlich das Modell auch erscheinen mag.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
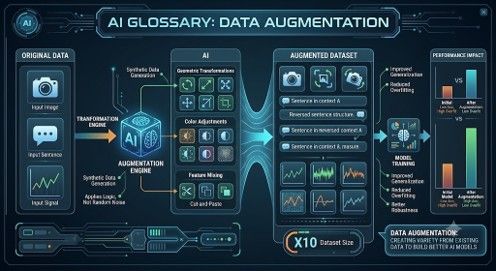
Datenaugmentierung
Datenaugmentierung bedeutet, modifizierte Versionen bestehender Trainingsbeispiele zu erstellen, um ein Modell zu verbessern. Bei Bildern kann dies das Drehen, Zuschneiden oder Ändern der Helligkeit umfassen. Bei Text kann es sich um Umschreibungen handeln. Das Ziel ist es, das Modell robuster zu machen, indem es Variationen ausgesetzt wird. Datenaugmentierung ist besonders nützlich, wenn der ursprüngliche Datensatz begrenzt ist.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
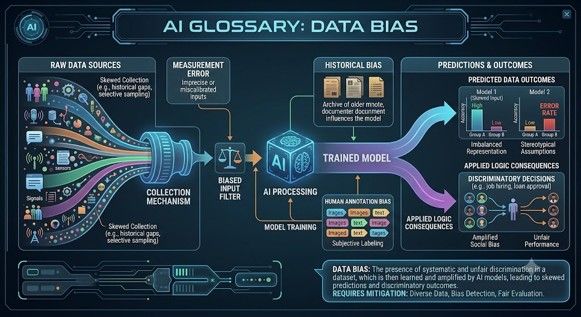
Datenverzerrung
Datenverzerrung tritt auf, wenn die zum Trainieren oder Testen eines KI-Systems verwendeten Daten nicht repräsentativ, unvollständig oder verzerrt sind. Beispielsweise kann ein Gesichtserkennungssystem, das hauptsächlich auf eine bestimmte demografische Gruppe trainiert wurde, bei anderen Gruppen schlechtere Ergebnisse erzielen. Datenverzerrung ist eine der Hauptursachen für ungerechtes oder unzuverlässiges KI-Verhalten.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
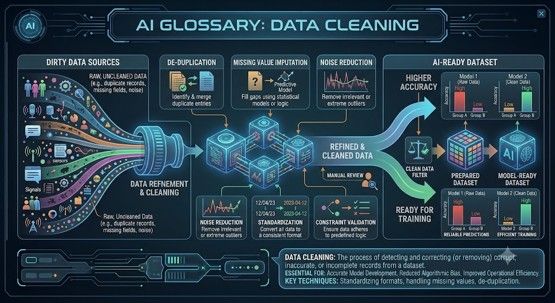
Datenbereinigung
Datenbereinigung ist der Prozess, bei dem unordentliche Daten vor ihrer Verwendung korrigiert, entfernt oder organisiert werden. Daten aus der Praxis enthalten oft Duplikate, fehlende Werte, Rechtschreibfehler, veraltete Einträge oder inkonsistente Formate. KI-Systeme sind in hohem Maße auf bereinigte Daten angewiesen. In vielen Projekten nimmt die Datenbereinigung mehr Zeit in Anspruch als die Erstellung des Modells.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
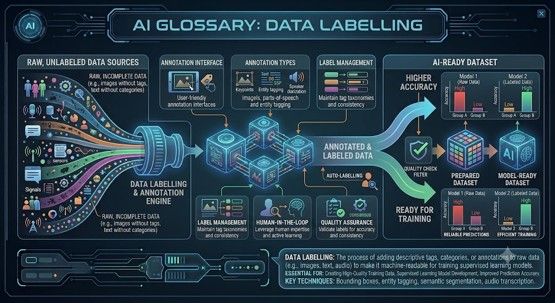
Datenbeschriftung
Die Datenbeschriftung ist der Prozess, bei dem Daten mit aussagekräftigen Tags versehen werden, damit ein KI-System daraus lernen kann. Beispielsweise hilft die Kennzeichnung von E-Mails als „Spam“ oder „kein Spam“ dabei, einen Spamfilter zu trainieren. Die Beschriftung medizinischer Bilder kann zum Training von Diagnosewerkzeugen beitragen. Eine gute Beschriftung erfordert klare Regeln und Qualitätskontrolle, insbesondere wenn Expertenurteile erforderlich sind.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
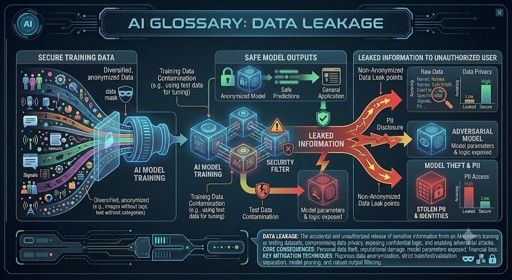
Datenleck
Ein Datenleck tritt auf, wenn Informationen aus den Testdaten versehentlich den Trainingsprozess beeinflussen. Dadurch erscheint das Modell besser, als es tatsächlich ist. Wird ein Modell beispielsweise mit Informationen trainiert, die in der Praxis nicht verfügbar wären, wird die Leistungsschätzung unzuverlässig. Datenlecks sind ein häufiger, aber schwerwiegender Fehler in Machine-Learning-Projekten.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
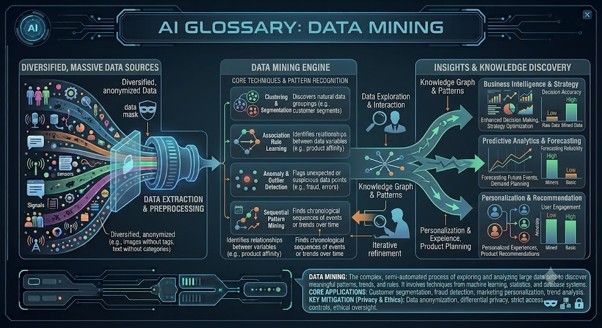
Data Mining
Data Mining ist der Prozess, bei dem Muster, Zusammenhänge oder nützliche Informationen in großen Datensätzen ermittelt werden. Es gab Data Mining bereits vor der modernen KI, doch es überschneidet sich mit maschinellem Lernen. Unternehmen nutzen Data Mining, um Kunden besser zu verstehen, Betrugsfälle aufzudecken, die Nachfrage zu prognostizieren und ihre Abläufe zu verbessern. Das Risiko besteht darin, dass Muster falsch interpretiert oder ohne angemessene Datenschutzvorkehrungen verwendet werden.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
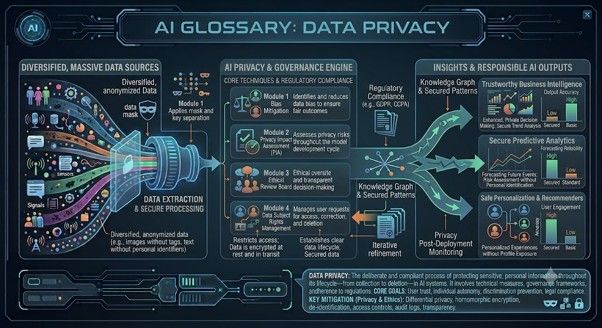
Datenschutz
Beim Datenschutz geht es darum, wie personenbezogene Daten erhoben, genutzt, gespeichert und weitergegeben werden. KI wirft neue Datenschutzbedenken auf, da Modelle anhand großer Datensätze trainiert werden können, die auch sensible Informationen enthalten. Unternehmen, die KI einsetzen, müssen Aspekte wie Einwilligung, Sicherheit, Anonymisierung, Aufbewahrungsfristen und die Einhaltung gesetzlicher Vorschriften berücksichtigen. Datenschutz ist nicht nur ein technisches Problem, sondern eine Frage des Vertrauens.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
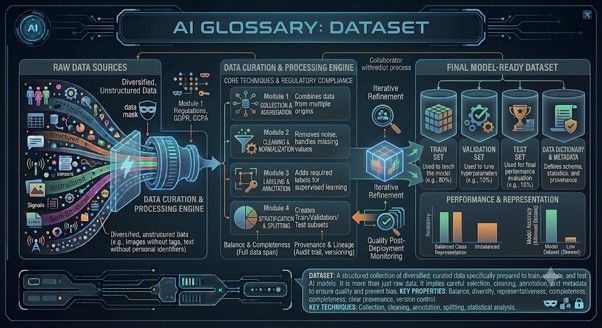
Datensatz
Ein Datensatz ist eine strukturierte Sammlung von Daten, die zum Trainieren, Testen oder Analysieren eines KI-Systems verwendet wird. Ein Datensatz kann Kundendaten, medizinische Bilder, Produktbewertungen, Finanztransaktionen oder beschriftete Fotos enthalten. Die Größe, Qualität und Repräsentativität des Datensatzes haben einen starken Einfluss auf die Leistung des Modells.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
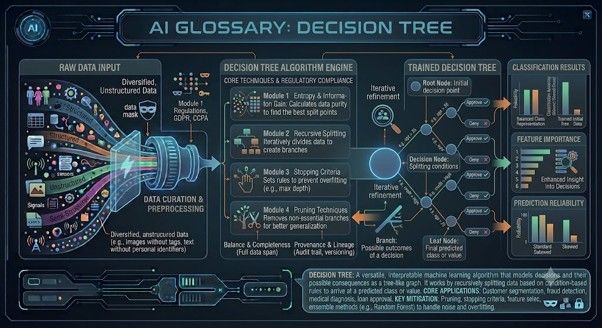
Entscheidungsbaum
Ein Entscheidungsbaum ist ein Modell des maschinellen Lernens, das anhand einer Abfolge von Fragen Entscheidungen trifft. Zum Beispiel: Ist der Kunde über 18 Jahre alt? Ist die Zahlung bereits einmal fehlgeschlagen? Ist die Transaktion ungewöhnlich hoch? Entscheidungsbäume sind beliebt, da sie leichter zu verstehen sind als viele Black-Box-Modelle. Sie werden häufig bei der Risikobewertung, Klassifizierung und bei Geschäftsregeln eingesetzt.
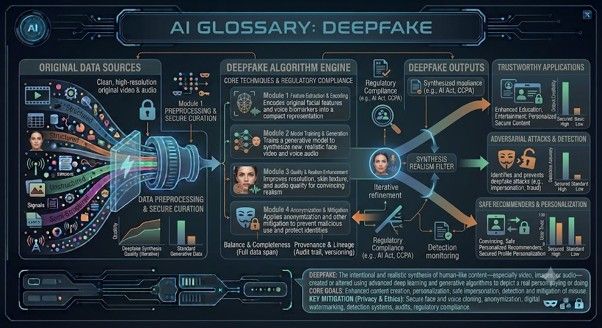 Bildquelle: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
Deepfake
Ein Deepfake ist ein durch KI erzeugtes oder manipuliertes Medieninhaltsstück, das den Anschein erweckt, dass jemand etwas sagt oder tut, was er in Wirklichkeit nicht gesagt oder getan hat. Deepfakes können zu Unterhaltungszwecken, aber auch für Betrug, Belästigung, Desinformation und politische Manipulation genutzt werden. Da Deepfakes immer realistischer werden, gewinnen Medienkompetenz und Faktenprüfung zunehmend an Bedeutung.
Legen Sie The Portugal News als Ihre bevorzugte Nachrichtenquelle bei Google fest
 Als bevorzugte Quelle bei Google hinzufügen





 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media