


 Créditos: Imagem cedida; Autor: Stephen Whitelaw;
Dall-E 3
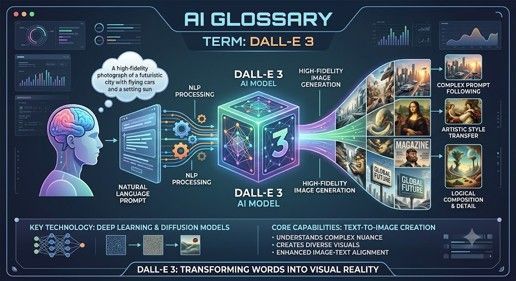
O DALL-E 3 foi um modelo de aprendizagem profunda de conversão de texto em imagem desenvolvido pela OpenAI que gerava imagens detalhadas e de alta resolução a partir de descrições em linguagem natural (prompts). Lançado no final de 2023, representou uma importante evolução em relação aos modelos visuais generativos anteriores, melhorando significativamente a fidelidade aos prompts, a qualidade da imagem e a representação de detalhes complexos.
Principais características e capacidades
· Compreensão da linguagem natural: Concebido de forma nativa para compreender nuances subtis, relações espaciais e contexto detalhado nas instruções dos utilizadores, sem necessidade de «engenharia de instruções» complexa.
· Representação de texto na imagem: Capaz de gerar texto claro e legível incorporado diretamente nas imagens (por exemplo, sinais, etiquetas, logótipos).
· Integração com o ChatGPT: Integrado nativamente no ChatGPT Plus/Enterprise, permitindo aos utilizadores debater ideias, aperfeiçoar e iterar sobre prompts visuais de forma coloquial.
· Segurança e proveniência: Incorpora mecanismos de segurança integrados para impedir a geração de conteúdo explícito, caricaturas de figuras públicas ou imitações do estilo de artistas vivos, e utiliza metadados de proveniência C2PA para identificar imagens geradas por IA.
Nota: O DALL-E 3 já não é, na sua maioria, utilizado como padrão, uma vez que a OpenAI e a Microsoft o retiraram oficialmente de serviço e o consideraram obsoleto. Foi substituído por sistemas multimodais nativos mais recentes
 Créditos: Imagem fornecida; Autor: Stephen Whitelaw;
Dados
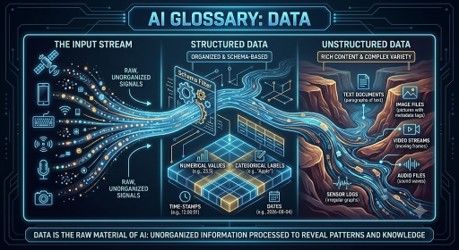
Os dados são a matéria-prima utilizada pelos sistemas de IA. Podem incluir texto, imagens, áudio, vídeo, números, transações, leituras de sensores ou registos médicos. Os sistemas de IA aprendem padrões a partir dos dados. A qualidade, a relevância e a imparcialidade dos dados são cruciais. Dados de má qualidade podem conduzir a uma IA de má qualidade, por mais avançado que o modelo pareça.
 Créditos: Imagem fornecida; Autor: Stephen Whitelaw;
Aumento de dados
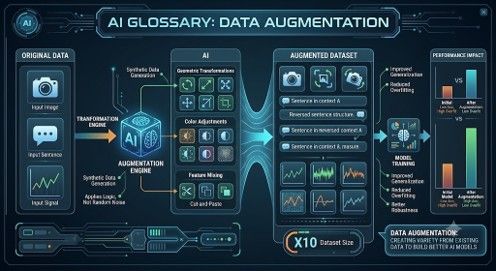
O aumento de dados consiste na criação de versões modificadas de exemplos de treino existentes para melhorar um modelo. No caso das imagens, isto pode incluir rodar, recortar ou alterar o brilho. No caso do texto, pode envolver parafrasear. O objetivo é tornar o modelo mais robusto, expondo-o a variações. O aumento de dados é especialmente útil quando o conjunto de dados original é limitado.
 Créditos: Imagem fornecida; Autor: Stephen Whitelaw;
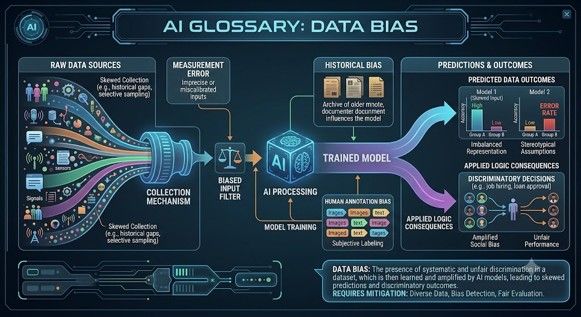
Viés de dados
O viés de dados ocorre quando os dados utilizados para treinar ou testar um sistema de IA não são representativos, estão incompletos ou são distorcidos. Por exemplo, um sistema de reconhecimento facial treinado principalmente com um grupo demográfico pode ter um desempenho inferior com outros grupos. O viés de dados é uma das principais causas de comportamentos injustos ou pouco fiáveis da IA.
 Créditos: Imagem fornecida; Autor: Stephen Whitelaw;
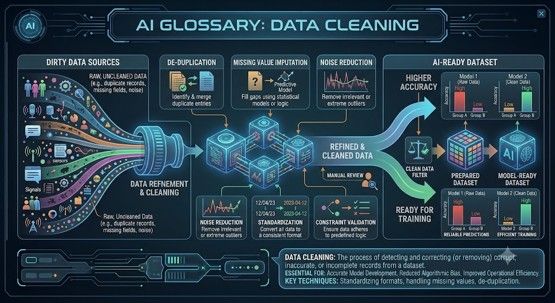
Limpeza de dados
A limpeza de dados é o processo de corrigir, remover ou organizar dados desorganizados antes de serem utilizados. Os dados do mundo real contêm frequentemente duplicados, valores em falta, erros ortográficos, registos desatualizados ou formatos inconsistentes. Os sistemas de IA dependem fortemente de dados limpos. Em muitos projetos, a limpeza de dados demora mais tempo do que a construção do modelo.
 Créditos: Imagem fornecida; Autor: Stephen Whitelaw;
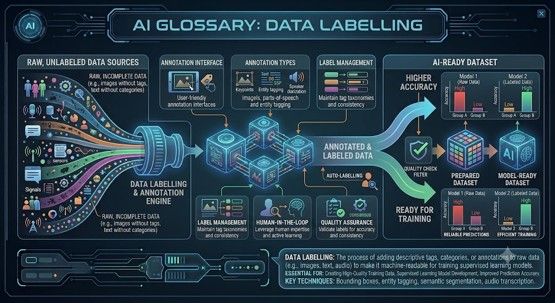
Rotulagem de dados
A rotulagem de dados é o processo de adicionar etiquetas significativas aos dados para que um sistema de IA possa aprender com eles. Por exemplo, rotular e-mails como «spam» ou «não spam» ajuda a treinar um filtro de spam. A rotulagem de imagens médicas pode ajudar a treinar ferramentas de diagnóstico. Uma boa rotulagem requer regras claras e controlo de qualidade, especialmente quando é necessário o parecer de um especialista.
 Créditos: Imagem fornecida; Autor: Stephen Whitelaw;
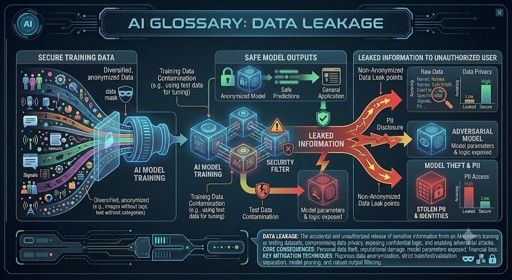
Fuga de dados
O vazamento de dados ocorre quando informações provenientes dos dados de teste influenciam acidentalmente o processo de treino. Isto faz com que o modelo pareça melhor do que realmente é. Por exemplo, se um modelo for treinado utilizando informações que não estariam disponíveis na vida real, a estimativa do seu desempenho torna-se pouco fiável. O vazamento de dados é um erro comum, mas grave, em projetos de aprendizagem automática.
 Créditos: Imagem fornecida; Autor: Stephen Whitelaw;
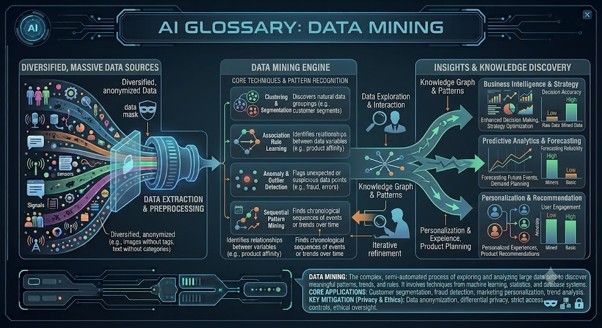
Mineração de dados
A mineração de dados é o processo de identificação de padrões, relações ou informações úteis em grandes conjuntos de dados. Já existia antes da IA moderna, mas sobrepõe-se ao aprendizado de máquina. As empresas utilizam a mineração de dados para compreender os clientes, detetar fraudes, prever a procura e melhorar as operações. O risco reside no facto de os padrões poderem ser mal interpretados ou utilizados sem as devidas salvaguardas de privacidade.
 Créditos: Imagem fornecida; Autor: Stephen Whitelaw;
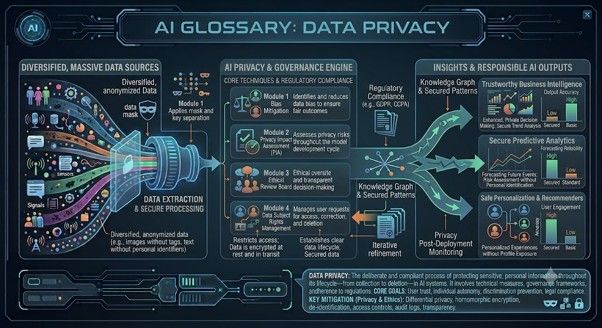
Privacidade de Dados
A privacidade de dados diz respeito à forma como as informações pessoais são recolhidas, utilizadas, armazenadas e partilhadas. A IA suscita novas preocupações em matéria de privacidade, uma vez que os modelos podem ser treinados com base em grandes conjuntos de dados, incluindo informações sensíveis. As organizações que utilizam IA têm de ter em conta o consentimento, a segurança, a anonimização, a retenção e a conformidade legal. A privacidade não é apenas uma questão técnica; é uma questão de confiança.
 Créditos: Imagem fornecida; Autor: Stephen Whitelaw;
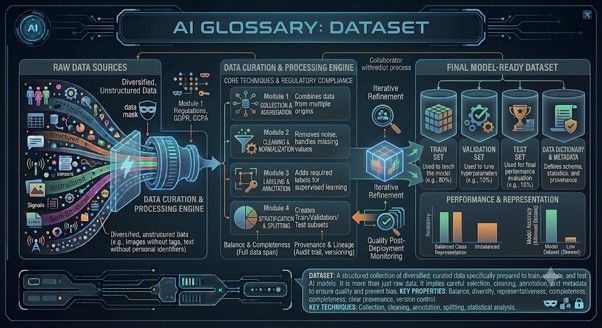
Conjunto de dados
Um conjunto de dados é uma coleção estruturada de dados utilizada para treinar, testar ou analisar um sistema de IA. Um conjunto de dados pode conter registos de clientes, imagens médicas, avaliações de produtos, transações financeiras ou fotografias rotuladas. A dimensão, a qualidade e a representatividade do conjunto de dados influenciam fortemente o desempenho do modelo.
 Créditos: Imagem fornecida; Autor: Stephen Whitelaw;
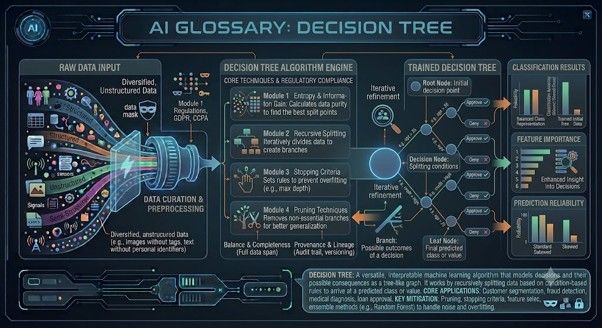
Árvore de decisão
Uma árvore de decisão é um modelo de aprendizagem automática que toma decisões através de uma sequência de perguntas. Por exemplo: O cliente tem mais de 18 anos? O pagamento já falhou anteriormente? A transação é invulgarmente elevada? As árvores de decisão são populares porque são mais fáceis de compreender do que muitos modelos de «caixa preta». São frequentemente utilizadas na pontuação de risco, na classificação e nas regras de negócio.
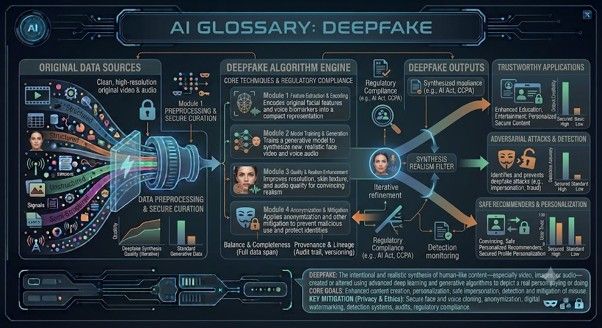 Créditos: Imagem fornecida; Autor: Stephen Whitelaw;
Deepfake
Um deepfake é um conteúdo multimédia gerado ou manipulado por IA que faz com que pareça que alguém diz ou faz algo que, na realidade, não disse nem fez. Os deepfakes podem ser utilizados para entretenimento, mas também para fraude, assédio, desinformação e manipulação política. À medida que os deepfakes se tornam mais realistas, a literacia mediática e a verificação tornam-se cada vez mais importantes.
Defina o The Portugal News como a sua fonte preferida de notícias no Google
 Adicionar como fonte preferida no Google





 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media